
优化 NetScaler VPX 在 VMware ESX、Linux KVM 和 Citrix Hypervisors 上的性能
NetScaler VPX 的性能因管理程序、分配的系统资源和主机配置而异。为了达到所需的性能,请首先遵循 VPX 数据表中的建议,然后使用本文档中提供的最佳实践进一步优化。
VMware ESX 管理程序上的 NetScaler VPX 实例
本节包含可配置选项和设置的详细信息,以及其他有助于您在 VMware ESX 管理程序上实现 NetScaler VPX 实例最佳性能的建议。
ESX 主机上的推荐配置
为了使使用 E1000、VMXNET3、SR-IOV 和 PCI 直通网络接口的 VPX 达到高性能,请遵循以下建议:
-
ESX 主机上配置的虚拟 CPU (vCPU) 总数必须小于或等于 ESX 主机上的物理 CPU (pCPU) 总数。
-
必须为 ESX 主机设置非统一内存访问 (NUMA) 亲和性和 CPU 亲和性才能获得良好结果。– 要查找 Vmnic 的 NUMA 亲和性,请本地或远程登录到主机,然后键入:
#vsish -e get /net/pNics/vmnic7/properties | grep NUMA
Device NUMA Node: 0-
要为 VM 设置 NUMA 和 vCPU 亲和性,请参阅 VMware 文档。
-
使用 E1000 网络接口的 NetScaler VPX
在 VMware ESX 主机上执行以下设置:
-
在 VMware ESX 主机上,从一个 pNIC vSwitch 创建两个 vNIC。多个 vNIC 会在 ESX 主机中创建多个接收 (Rx) 线程。这会增加 pNIC 接口的 Rx 吞吐量。
-
为您创建的每个 vNIC 在 vSwitch 端口组级别启用 VLAN。
-
为了提高 vNIC 传输 (Tx) 吞吐量,请在 ESX 主机中为每个 vNIC 使用单独的 Tx 线程。使用以下 ESX 命令:
-
对于 ESX 5.5 版本:
esxcli system settings advanced set –o /Net/NetTxWorldlet –i -
对于 ESX 6.0 及更高版本:
esxcli system settings advanced set -o /Net/NetVMTxType –i 1
-
-
为了进一步提高 vNIC Tx 吞吐量,请为每个设备 (NIC) 队列使用单独的 Tx 完成线程和 Rx 线程。使用以下 ESX 命令:
esxcli system settings advanced set -o /Net/NetNetqRxQueueFeatPairEnable -i 0
注意:
请务必重新启动 VMware ESX 主机以应用更新的设置。
每个 pNIC 部署两个 vNIC
以下是“每个 pNIC 两个 vNIC”部署模型的示例拓扑和配置命令,该模型可提供更好的网络性能。
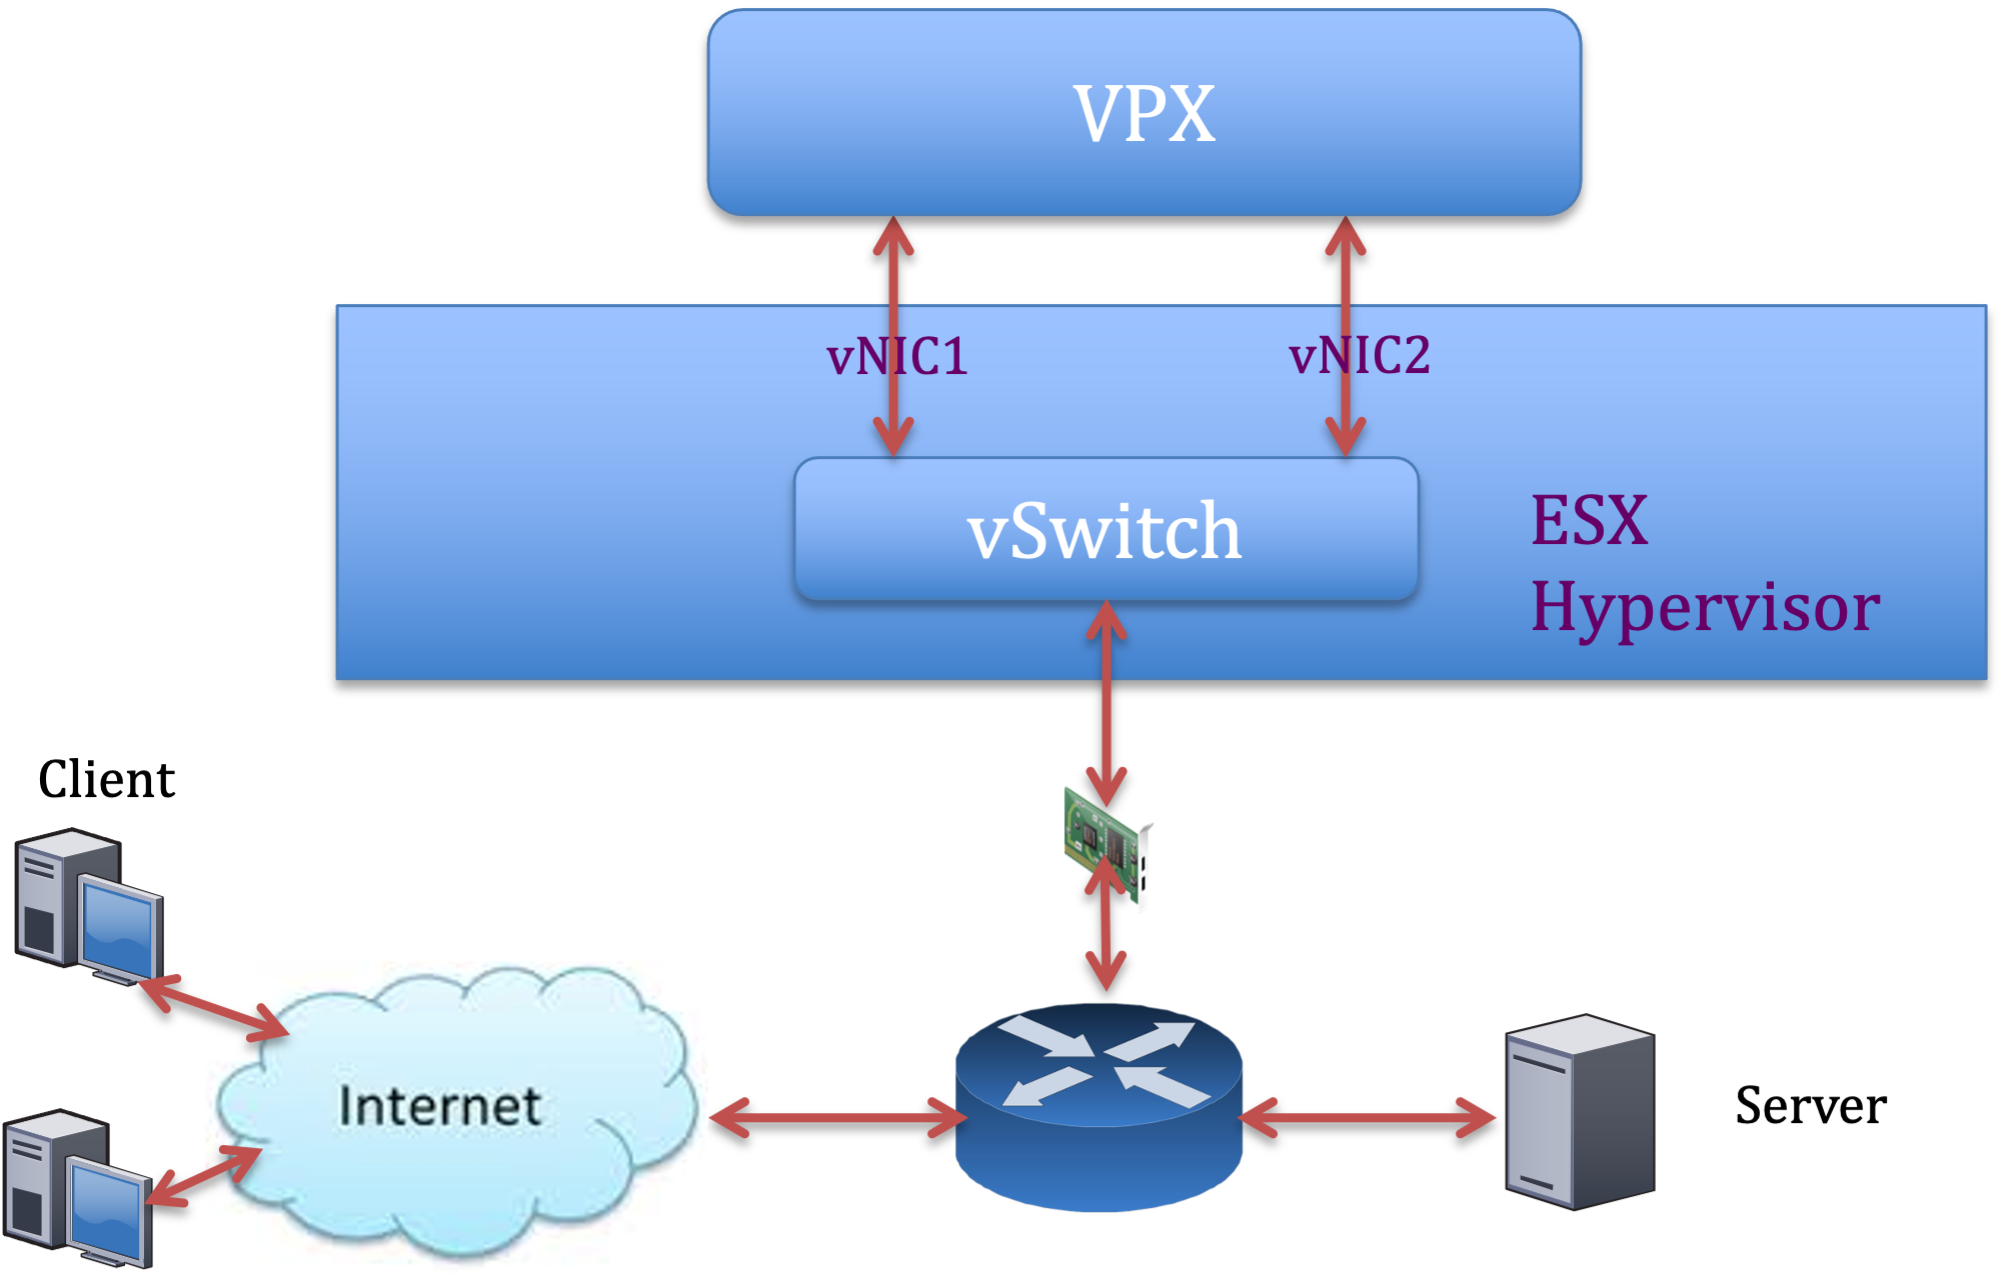
NetScaler VPX 示例配置:
要实现上述示例拓扑中所示的部署,请在 NetScaler VPX 实例上执行以下配置:
-
在客户端,将 SNIP (1.1.1.2) 绑定到网络接口 1/1 并启用 VLAN 标记模式。
bind vlan 2 -ifnum 1/1 –tagged
bind vlan 2 -IPAddress 1.1.1.2 255.255.255.0 -
在服务器端,将 SNIP (2.2.2.2) 绑定到网络接口 1/1 并启用 VLAN 标记模式。
bind vlan 3 -ifnum 1/2 –tagged
bind vlan 3 -IPAddress 2.2.2.2 255.255.255.0 -
添加一个 HTTP 虚拟服务器 (1.1.1.100) 并将其绑定到服务 (2.2.2.100)。
add lb vserver v1 HTTP 1.1.1.100 80 -persistenceType NONE -Listenpolicy None -cltTimeout 180
 add service s1 2.2.2.100 HTTP 80 -gslb NONE -maxClient 0 -maxReq 0 -cip DISABLED -usip NO -useproxyport YES -sp ON -cltTimeout 180 -svrTimeout 360 -CKA NO -TCPB NO -CMP NO
 bind lb vserver v1 s1
注意:
确保在路由表中包含以下两个条目:
-
1.1.1.0/24 子网,网关指向 SNIP 1.1.1.2
-
2.2.2.0/24 子网,网关指向 SNIP 2.2.2.2
采用 VMXNET3 网络接口的 NetScaler VPX
为了使采用 VMXNET3 网络接口的 VPX 达到高性能,请在 VMware ESX 主机上执行以下设置:
-
从一个 pNIC vSwitch 创建两个 vNIC。多个 vNIC 会在 ESX 主机中创建多个 Rx 线程。这会增加 pNIC 接口的 Rx 吞吐量。
-
在 vSwitch 端口组级别为您创建的每个 vNIC 启用 VLAN。
-
为了提高 vNIC 传输 (Tx) 吞吐量,请为每个 vNIC 在 ESX 主机中使用单独的 Tx 线程。使用以下 ESX 命令:
-
对于 ESX 5.5 版本:
esxcli system settings advanced set –o /Net/NetTxWorldlet –i-
对于 ESX 6.0 及更高版本:
esxcli system settings advanced set -o /Net/NetVMTxType –i 1 -
在 VMware ESX 主机上,执行以下配置:
-
在 VMware ESX 主机上,从 1 个 pNIC vSwitch 创建两个 vNIC。多个 vNIC 会在 ESX 主机中创建多个 Tx 和 Rx 线程。这会增加 pNIC 接口的 Tx 和 Rx 吞吐量。
-
为您创建的每个 vNIC 在 vSwitch 端口组级别启用 VLAN。
-
为提高 vNIC 的 Tx 吞吐量,请为每个设备 (NIC) 队列使用单独的 Tx 完成线程和 Rx 线程。使用以下命令:
esxcli system settings advanced set -o /Net/NetNetqRxQueueFeatPairEnable -i 0 -
通过将以下设置添加到 VM 的配置中,将 VM 配置为每个 vNIC 使用一个传输线程:
ethernetX.ctxPerDev = "1" -
通过将以下设置添加到 VM 的配置中,将 VM 配置为每个 vNIC 最多使用 8 个传输线程:
ethernetX.ctxPerDev = "3"注意:增加每个 vNIC 的传输线程(最多 8 个)需要 ESX 主机上更多的 CPU 资源。在进行上述设置之前,请确保有足够的 CPU 资源可用。
注意:
确保重新启动 VMware ESX 主机以应用更新的设置。
您可以将 VMXNET3 配置为每个 pNIC 两个 vNIC部署。有关更多信息,请参阅每个 pNIC 两个 vNIC 部署。
在 VMware ESX 上为 VMXNET3 设备配置多队列和 RSS 支持
默认情况下,VMXNET3 设备仅支持 8 个 Rx 和 Tx 队列。当 VPX 上的 vCPU 数量超过 8 个时,为 VMXNET3 接口配置的 Rx 和 Tx 队列数量默认切换为 1。您可以通过更改 ESX 上的某些配置,为 VMXNET3 设备配置最多 19 个 Rx 和 Tx 队列。此选项可提高性能并使数据包在 VPX 实例的 vCPU 之间均匀分布。
注意:
从 NetScaler 13.1 版本 build 48.x 开始,NetScaler VPX 在 ESX 上为 VMXNET3 设备支持最多 19 个 Rx 和 Tx 队列。
先决条件:
要在 ESX 上为 VMXNET3 设备配置最多 19 个 Rx 和 Tx 队列,请确保满足以下先决条件:
-
NetScaler VPX 版本为 13.1 build 48.X 及更高版本。
-
NetScaler VPX 配置为硬件版本 17 及更高版本的虚拟机,该版本受 VMware ESX 7.0 及更高版本支持。
配置 VMXNET3 接口以支持 8 个以上的 Rx 和 Tx 队列:
-
打开虚拟机配置文件 (.vmx) 文件。
-
通过配置
ethernetX.maxTxQueues和ethernetX.maxRxQueues值来指定 Rx 和 TX 队列的数量(其中 X 是要配置的虚拟 NIC 的数量)。配置的最大队列数不得大于虚拟机中的 vCPU 数量。注意:增加队列数量也会增加 ESX 主机上的处理器开销。因此,在增加队列之前,请确保 ESX 主机中有足够的 CPU 资源。在队列数量被确定为性能瓶颈的情况下,您可以增加支持的最大队列数量。在这种情况下,我们建议逐渐增加队列数量。例如,从 8 增加到 12,然后到 16,再到 20,依此类推。在每个设置下评估性能,而不是直接增加到最大限制。
具有 SR-IOV 和 PCI 直通网络接口的 NetScaler VPX
要实现具有 SR-IOV 和 PCI 直通网络接口的 NetScaler VPX 的高性能,请参阅ESX 主机上的推荐配置。
VMware ESXi 虚拟机管理程序使用指南
-
建议您将 NetScaler VPX 实例部署在服务器的本地磁盘或基于 SAN 的存储卷上。请参阅 VMware vSphere 6.5 性能最佳实践 文档中的“VMware ESXi CPU 注意事项”部分。以下是摘录:
-
不建议在过度承诺的主机或群集上部署具有高 CPU 或内存需求的虚拟机。
-
在大多数环境中,ESXi 允许在不影响虚拟机性能的情况下进行大量的 CPU 过度承诺。在主机上,您可以运行的 vCPU 数量多于该主机中物理处理器核心的总数。
-
如果 ESXi 主机达到 CPU 饱和状态,即主机上的虚拟机和其他负载需要主机拥有的所有 CPU 资源,则对延迟敏感的工作负载可能无法很好地运行。在这种情况下,请减少 CPU 负载,例如,通过关闭某些虚拟机或将其迁移到不同的主机(或允许 DRS 自动迁移它们)。
-
NetScaler 建议使用最新的硬件兼容性版本,以利用 ESXi 虚拟机管理程序为虚拟机提供的最新功能集。有关硬件和 ESXi 版本兼容性的更多信息,请参阅 VMware 文档。
-
NetScaler VPX 是一种对延迟敏感的高性能虚拟设备。为了提供其预期的性能,该设备需要在主机上进行 vCPU 预留、内存预留和 vCPU 绑定。此外,主机上必须禁用超线程。如果主机不满足这些要求,可能会出现以下问题:
-
高可用性故障转移
-
VPX 实例内的 CPU 峰值
-
访问 VPX CLI 时出现迟钝
-
Pit boss 守护程序崩溃
-
数据包丢失
-
低吞吐量
-
-
如果满足以下两个条件之一,则虚拟机管理程序被视为过度配置:
-
主机上配置的虚拟核心 (vCPU) 总数大于物理核心 (pCPU) 总数。
-
配置的虚拟机总数消耗的 vCPU 数量多于 pCPU 总数。如果实例过度配置,虚拟机管理程序可能无法保证为该实例预留的资源(例如 CPU、内存等),这可能是由于虚拟机管理程序调度开销、错误或虚拟机管理程序限制所致。这种行为可能导致 NetScaler 缺少 CPU 资源,并可能导致使用指南中第一点提到的问题。我们建议管理员减少主机的租用,以便主机上配置的 vCPU 总数小于或等于 pCPU 总数。示例:对于 ESX 虚拟机管理程序,如果在
esxtop命令输出中,VPX vCPU 的%RDY%参数大于 0,则表示 ESX 主机存在调度开销,这可能导致 VPX 实例出现与延迟相关的问题。在这种情况下,请减少主机的租用,以便%RDY%始终返回 0。或者,联系虚拟机管理程序供应商,以排查未遵守资源预留的原因。
-
控制数据包引擎 CPU 使用率的命令
您可以使用两个命令 (
set ns vpxparam 和 show ns vpxparam) 来控制虚拟机管理程序和云环境中 VPX 实例的数据包引擎(非管理)CPU 使用行为:
-
set ns vpxparam [-cpuyield (YES | NO | DEFAULT)] [-masterclockcpu1 (YES | NO)]允许每个虚拟机使用分配给另一个虚拟机但未使用的 CPU 资源。Set ns vpxparam参数:-cpuyield:释放或不释放已分配但未使用的 CPU 资源。-
YES:允许已分配但未使用的 CPU 资源被另一个虚拟机使用。
-
NO:为已分配的虚拟机保留所有 CPU 资源。此选项在虚拟机管理程序和云环境中显示更高的 VPX CPU 使用率百分比。
-
DEFAULT:否。
注意:在所有 NetScaler VPX 平台上,主机系统上的 vCPU 使用率为 100%。使用set ns vpxparam –cpuyield YES命令覆盖此使用率。如果要将群集节点设置为“yield”,您必须在 CCO 上执行以下额外配置:-
如果形成群集,所有节点都设置为“yield=DEFAULT”。
-
如果使用已设置为“yield=YES”的节点形成群集,则使用“DEFAULT”yield 将节点添加到群集。
注意:如果您想将集群节点设置为“yield=YES”,只能在集群形成后进行配置,而不能在集群形成之前进行配置。-masterclockcpu1:您可以将主时钟源从 CPU0(管理 CPU)移动到 CPU1。此参数具有以下选项:-
YES:允许虚拟机将主时钟源从 CPU0 移动到 CPU1。
-
NO:虚拟机使用 CPU0 作为主时钟源。默认情况下,CPU0 是主时钟源。
-
-
show ns vpxparam此命令显示当前的vpxparam设置。
Linux-KVM 平台上的 NetScaler VPX 实例
本节包含可配置选项和设置的详细信息,以及其他有助于您在 Linux-KVM 平台上实现 NetScaler VPX 实例最佳性能的建议。
KVM 的性能设置
在 KVM 主机上执行以下设置:
使用
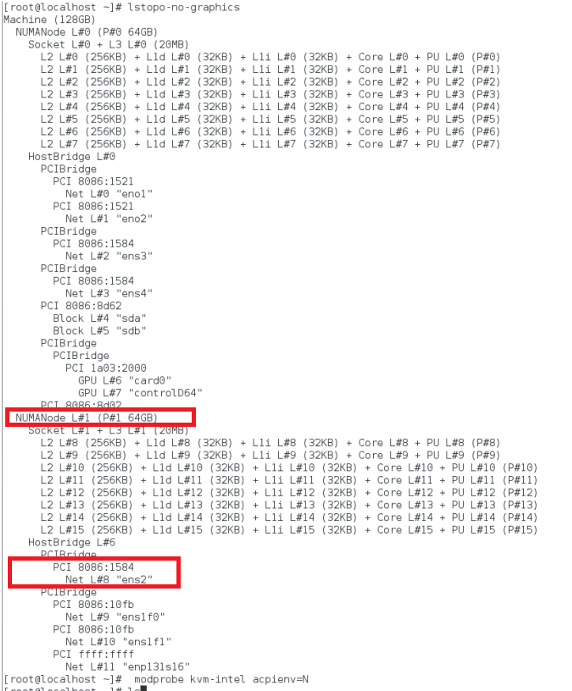
lstopo 命令查找 NIC 的 NUMA 域:
确保 VPX 和 CPU 的内存固定在同一位置。 在以下输出中,10G NIC "ens2" 绑定到 NUMA 域 #1。
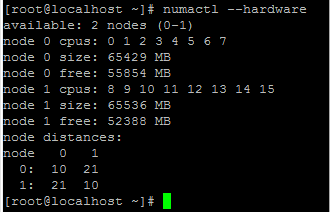
从 NUMA 域分配 VPX 内存。
numactl 命令指示内存分配自哪个 NUMA 域。在以下输出中,大约 10 GB RAM 从 NUMA 节点 #0 分配。
要更改 NUMA 节点映射,请按照以下步骤操作。
-
编辑主机上 VPX 的 .xml 文件。
/etc/libvirt/qemu/<VPX_name>.xml -
添加以下标签:
<numatune>
<memory mode="strict" nodeset="1"/> This is the NUMA domain name
</numatune> -
关闭 VPX。
-
运行以下命令:
virsh define /etc/libvirt/qemu/<VPX_name>.xml此命令使用 NUMA 节点映射更新 VM 的配置信息。 -
启动 VPX。然后检查主机上的
numactl –hardware命令输出,查看 VPX 更新后的内存分配。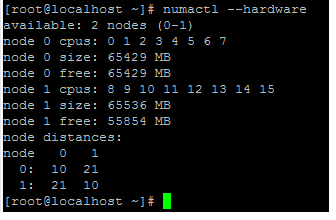
将 VPX 的 vCPU 绑定到物理核心。
-
要查看 VPX 的 vCPU 到 pCPU 映射,请键入以下命令
virsh vcpupin <VPX name>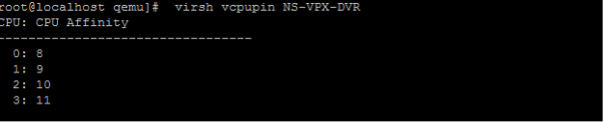 vCPU 0-4 映射到物理核心 8-11。
-
要查看当前的 pCPU 使用情况,请键入以下命令:
mpstat -P ALL 5mpstat 命令的输出 (/en-us/vpx/media/mpstat-output.png)在此输出中,8 是管理 CPU,9-11 是数据包引擎。 -
要更改 vCPU 到 pCPU 的绑定,有两种选择。
-
在 VPX 启动后,使用以下命令在运行时更改它:
virsh vcpupin <VPX name> <vCPU id>  <pCPU number>
 virsh vcpupin NetScaler-VPX-XML 0 8
 virsh vcpupin NetScaler-VPX-XML 1 9
 virsh vcpupin NetScaler-VPX-XML 2 10
virsh vcpupin NetScaler-VPX-XML 3 11 -
要对 VPX 进行静态更改,请像以前一样使用以下标签编辑
.xml文件:-
编辑主机上 VPX 的 .xml 文件
/etc/libvirt/qemu/<VPX_name>.xml -
添加以下标签:
<vcpu placement='static' cpuset='8-11'>4</vcpu>
     <cputune>
         <vcpupin vcpu='0' cpuset='8'/>
         <vcpupin vcpu='1' cpuset='9'/>
         <vcpupin vcpu='2' cpuset='10'/>
         <vcpupin vcpu='3' cpuset='11'/>
</cputune> -
关闭 VPX。
-
使用以下命令更新虚拟机的配置信息,其中包含 NUMA 节点映射:
virsh define /etc/libvirt/qemu/ <VPX_name>.xml -
启动 VPX。然后检查主机上的
virsh vcpupin <VPX name>命令输出,查看更新后的 CPU 绑定。
-
-
消除主机中断开销。
-
使用
kvm_stat命令检测 VM_EXITS。在管理程序级别,主机中断被映射到与 VPX 的 vCPU 绑定的相同 pCPU 上。这可能会导致 VPX 上的 vCPU 定期被踢出。要查找主机上运行的 VM 完成的 VM 退出,请使用kvm_stat命令。[root@localhost ~]# kvm_stat -1 | grep EXTERNAL
kvm_exit(EXTERNAL_INTERRUPT) 1728349 27738
[root@localhost ~]#如果值达到 1M 或更高,则表示存在问题。如果只有一个 VM,则预期值为 30–100 K。任何超出此范围的值都可能表明有一个或多个主机中断向量映射到同一个 pCPU。 -
检测主机中断并迁移主机中断。当您对“/proc/interrupts”文件运行
concatenate命令时,它会显示所有主机中断映射。如果一个或多个活动 IRQ 映射到同一个 pCPU,则其对应的计数器会递增。将与 NetScaler VPX 的 pCPU 重叠的任何中断移动到未使用的 pCPU:echo 0000000f > /proc/irq/55/smp_affinity
0000000f - - > it is a bitmap, LSBs indicates that IRQ 55 can only be scheduled on pCPUs 0 – 3 -
禁用 IRQ 平衡。禁用 IRQ 平衡守护程序,以便不会即时重新调度。
service irqbalance stop
 service irqbalance show - To check the status
service irqbalance start - Enable if needed请务必运行kvm_stat命令,以确保计数器数量不多。
具有 PV 网络接口的 NetScaler VPX
您可以将半虚拟化 (PV)、SR-IOV 和 PCIe 直通网络接口配置为每个 pNIC 两个 vNIC 部署。有关更多信息,请参阅每个 pNIC 两个 vNIC 部署。
为了获得 PV (virtio) 接口的最佳性能,请按照以下步骤操作:
-
识别 PCIe 插槽/网卡所属的 NUMA 域。
-
VPX 的内存和 vCPU 必须固定到同一个 NUMA 域。
-
Vhost 线程必须绑定到同一 NUMA 域中的 CPU。
将虚拟主机线程绑定到相应的 CPU:
-
流量启动后,在主机上运行
top命令。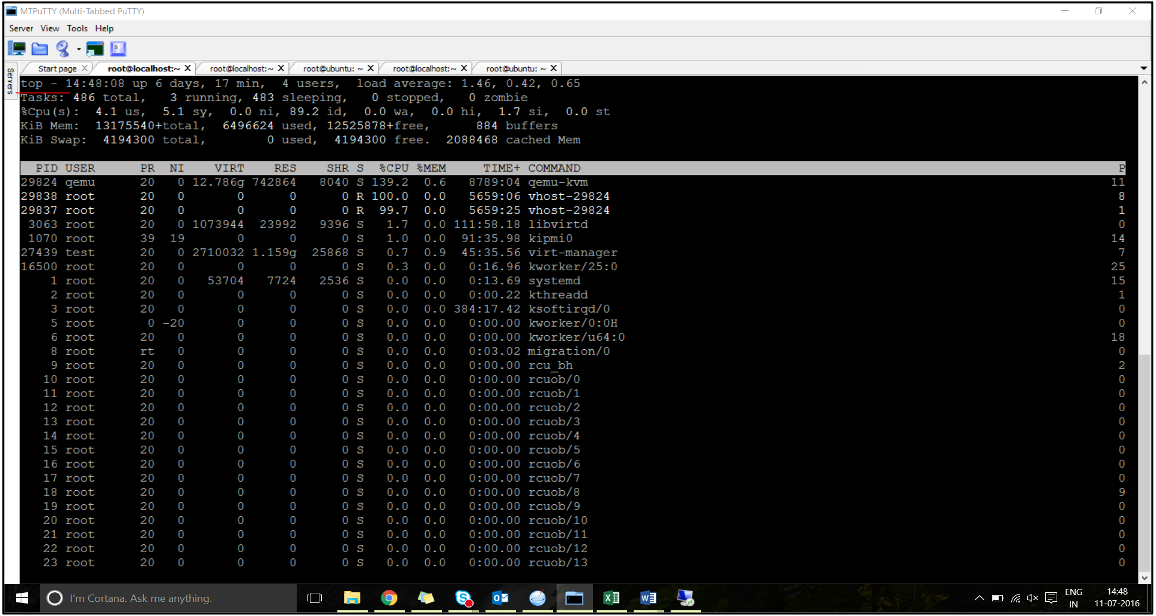
-
识别虚拟主机进程(命名为
vhost-<pid-of-qemu>)的亲和性。 -
使用以下命令将 vHost 进程绑定到之前识别的 NUMA 域中的物理核心:
taskset –pc <core-id> <process-id>示例:taskset –pc 12 29838 -
可以使用以下命令识别与 NUMA 域对应的处理器核心:
[root@localhost ~]# virsh capabilities | grep cpu
 <cpu>
     </cpu>
         <cpus num='8'>
             <cpu id='0' socket_id='0' core_id='0' siblings='0'/>
             <cpu id='1' socket_id='0' core_id='1' siblings='1'/>
             <cpu id='2' socket_id='0' core_id='2' siblings='2'/>
             <cpu id='3' socket_id='0' core_id='3' siblings='3'/>
             <cpu id='4' socket_id='0' core_id='4' siblings='4'/>
             <cpu id='5' socket_id='0' core_id='5' siblings='5'/>
             <cpu id='6' socket_id='0' core_id='6' siblings='6'/>
             <cpu id='7' socket_id='0' core_id='7' siblings='7'/>
         </cpus>

         <cpus num='8'>
         <cpu id='8' socket_id='1' core_id='0' siblings='8'/>
         <cpu id='9' socket_id='1' core_id='1' siblings='9'/>
         <cpu id='10' socket_id='1' core_id='2' siblings='10'/>
         <cpu id='11' socket_id='1' core_id='3' siblings='11'/>
         <cpu id='12' socket_id='1' core_id='4' siblings='12'/>
         <cpu id='13' socket_id='1' core_id='5' siblings='13'/>
         <cpu id='14' socket_id='1' core_id='6' siblings='14'/>
         <cpu id='15' socket_id='1' core_id='7' siblings='15'/>
         </cpus>

     <cpuselection/>
     <cpuselection/>
将 QEMU 进程绑定到相应的物理核心:
-
识别 QEMU 进程正在运行的物理核心。有关详细信息,请参阅前面的输出。
-
使用以下命令将 QEMU 进程绑定到与绑定 vCPU 相同的物理核心:
taskset –pc 8-11 29824
具有 SR-IOV 和 Fortville PCIe 直通网络接口的 NetScaler VPX
为了获得 SR-IOV 和 Fortville PCIe 直通网络接口的最佳性能,请按照以下步骤操作:
-
识别 PCIe 插槽/网卡所属的 NUMA 域。
-
NetScaler VPX 的内存和 vCPU 必须固定到相同的 NUMA 域。
适用于 Linux KVM 的 vCPU 和内存固定示例 VPX XML 文件:
    <domain type='kvm'>
         <name>NetScaler-VPX</name>
         <uuid>138f7782-1cd3-484b-8b6d-7604f35b14f4</uuid>
         <memory unit='KiB'>8097152</memory>
         <currentMemory unit='KiB'>8097152</currentMemory>
         <vcpu placement='static'>4</vcpu>

     <cputune>
         <vcpupin vcpu='0' cpuset='8'/>
         <vcpupin vcpu='1' cpuset='9'/>
         <vcpupin vcpu='2' cpuset='10'/>
         <vcpupin vcpu='3' cpuset='11'/>
     </cputune>

     <numatune>
     <memory mode='strict' nodeset='1'/>
     </numatune>

     </domain>
Citrix Hypervisors 上的 NetScaler VPX 实例
本节包含可配置选项和设置的详细信息,以及其他有助于您在 Citrix Hypervisors 上实现 NetScaler VPX 实例最佳性能的建议。
Citrix Hypervisors 的性能设置
使用“xl”命令查找 NIC 的 NUMA 域:
xl info -n
将 VPX 的 vCPU 绑定到物理核心。
xl vcpu-pin <Netsclaer VM Name> <vCPU id> <physical CPU id>
检查 vCPU 的绑定。
xl vcpu-list
为 NetScaler VM 分配超过 8 个 vCPU。
要配置超过 8 个 vCPU,请从 Citrix Hypervisor™ 控制台运行以下命令:
xe vm-param-set uuid=your_vms_uuid VCPUs-max=16
 xe vm-param-set uuid=your_vms_uuid VCPUs-at-startup=16
具有 SR-IOV 网络接口的 NetScaler VPX
为了获得 SR-IOV 网络接口的最佳性能,请遵循以下步骤:
-
确定 PCIe 插槽或 NIC 所绑定的 NUMA 域。
-
将 VPX 的内存和 vCPU 绑定到相同的 NUMA 域。
-
将 Domain-0 vCPU 绑定到剩余的 CPU。
具有半虚拟化接口的 NetScaler VPX
为获得最佳性能,建议采用每个 pNIC 两个 vNIC 和每个 pNIC 一个 vNIC 的配置,这与其他 PV 环境相同。
为实现半虚拟化 (netfront) 接口的最佳性能,请遵循以下步骤:
-
确定 PCIe 插槽或 NIC 所属的 NUMA 域。
-
将 VPX 的内存和 vCPU 固定到相同的 NUMA 域。
-
将 Domain-0 vCPU 绑定到相同 NUMA 域的剩余 CPU。
-
将 vNIC 的主机 Rx/Tx 线程固定到 Domain-0 vCPU。
将主机线程固定到 Domain-0 vCPU:
-
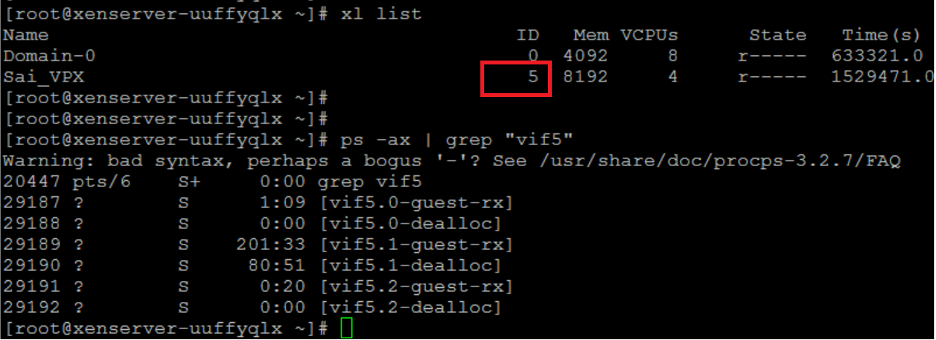
通过在 Citrix Hypervisor 主机 shell 上使用
xl list命令查找 NetScaler VPX 的 Xen-ID。 -
使用以下命令识别主机线程:
ps -ax | grep vif <Xen-ID>在以下示例中,这些值表示:-
vif5.0 - 分配给 XenCenter 中 VPX 的第一个接口(管理接口)的线程。
-
vif5.1 - 分配给 VPX 的第二个接口的线程,依此类推。
-
-
使用以下命令将线程固定到 Domain-0 vCPU:
taskset –pc <core-id> <process-id>示例:taskset -pc 1 29189