
查看服务详细信息
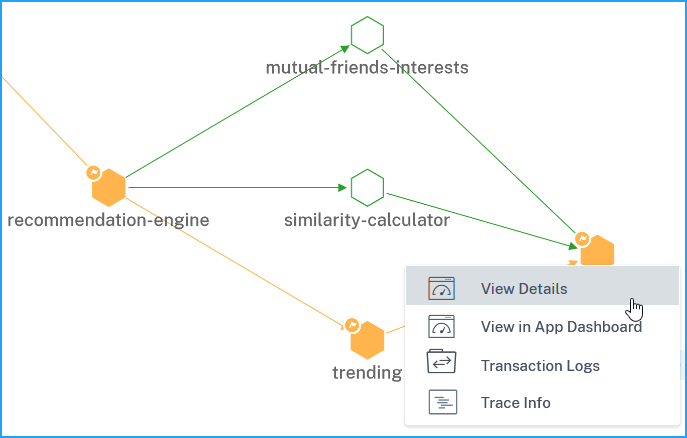
单击服务并选择查看详细信息。
服务详细信息页面可让您查看:
-
托管服务的集群名称 (1)
-
服务的命名空间和服务标签 (2) (4)
-
与所选服务关联的所有传入和传出服务 (3)
-
以图表形式显示服务关键指标,例如命中数、响应时间、错误、数据量、SSL 前端错误和 TCP 前端错误。带异常的指标选项卡可让您查看特定持续时间的异常 (5)。有关更多信息,请参阅使用黄金信号指标监控服务。
-
与服务关联的后端 Pod (6)。
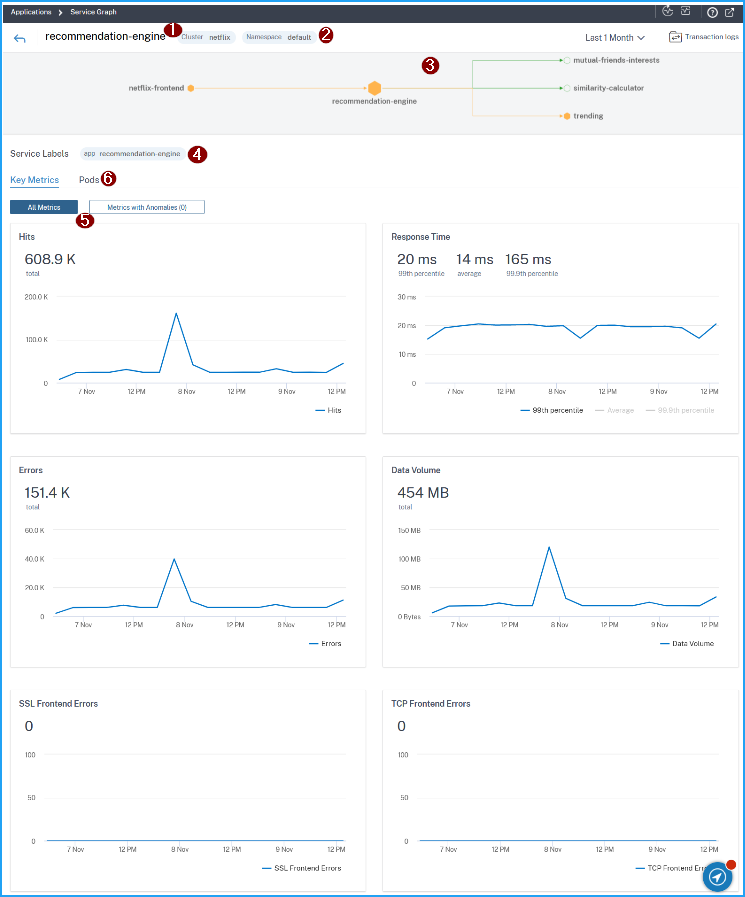
利用这些关键指标趋势,您可以分析服务在特定时间段内的性能。
例如,假设某个服务指示所有请求的服务响应时间 > 700 毫秒。作为管理员,您可以:
-
分析特定持续时间的服务响应时间指标趋势
-
排查问题
-
再次检查服务响应时间指标,以分析响应时间是否有所改善
指标详情
| 指标 | 描述 |
|---|---|
| 命中数 | 服务收到的请求总数 |
| 错误 | 服务中的 HTTP 错误总数 |
| 服务响应时间 | 服务响应首字节时间 (TTFB) 所用的平均响应时间。 |
| 数据量 | 服务处理的数据总量 |
| SSL 前端错误 | 服务中的 SSL 前端错误总数。例如:SSL 客户端身份验证失败 |
| SSL 后端错误 | 服务产生的SSL后端错误总数。例如:SSL客户端错误 |
| TCP后端错误 | 服务产生的TCP后端错误总数。例如:TCP服务器重置 |
| TCP前端错误 | 服务产生的TCP前端错误总数。例如:TCP客户端重置 |
查看后端Pod详细信息
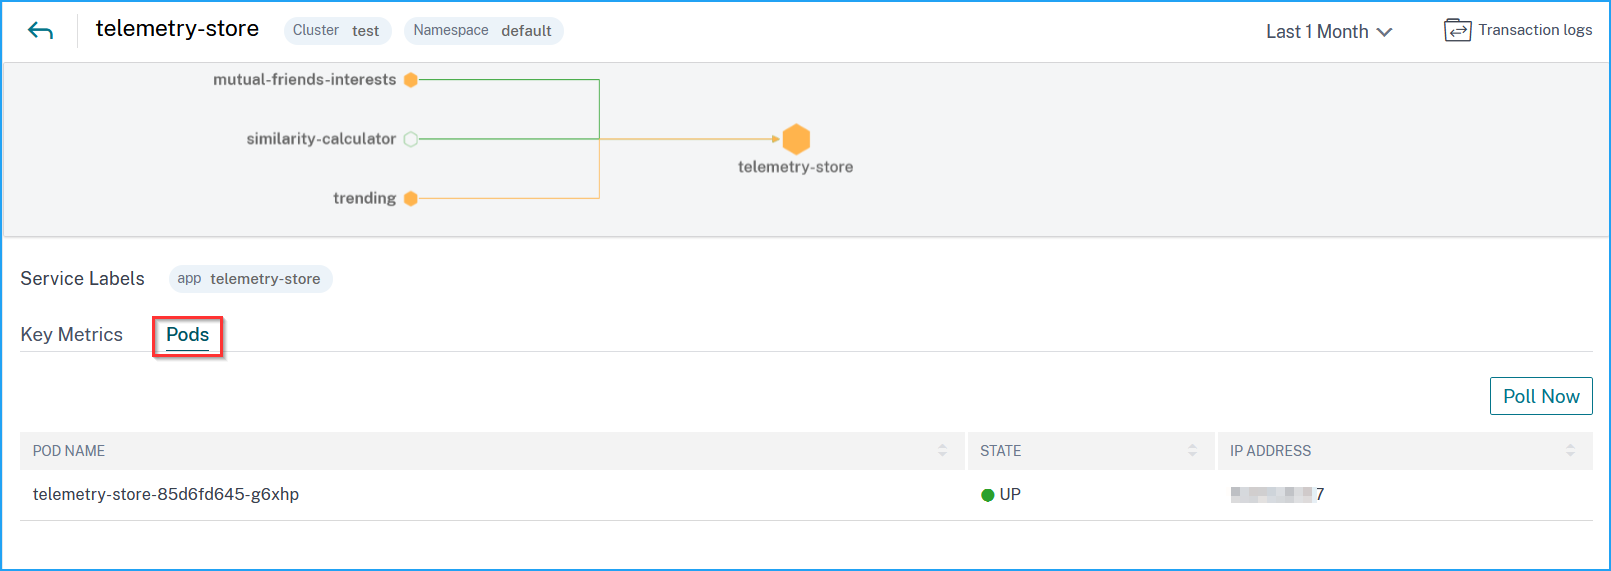
单击“Pods”选项卡以查看与服务关联的后端Pod。
-
Pod名称 – 表示Pod名称
-
状态 – 表示Pod是否正在运行 (UP) 或未运行 (DOWN)。
-
IP地址 – 表示Pod的IP地址
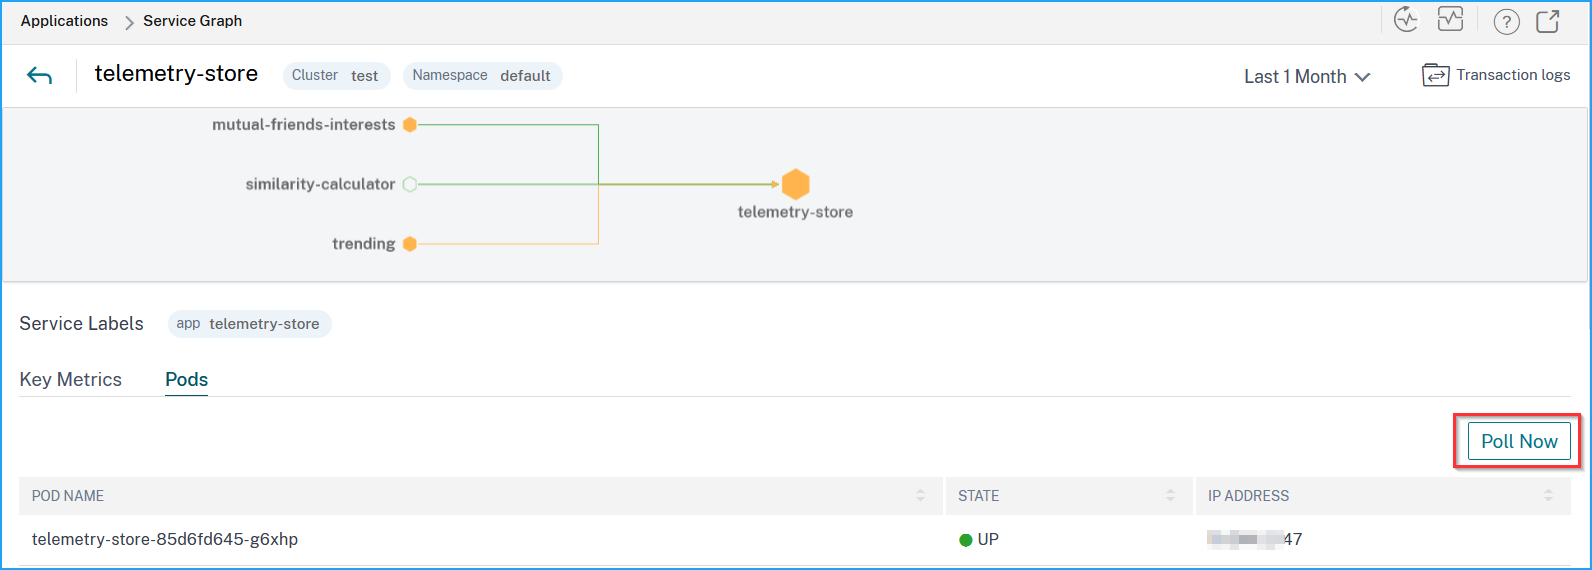
使用“立即轮询”选项获取Pod状态
“立即轮询”选项从集群中获取最新的Pod状态。
使用黄金信号指标监控服务
Kubernetes 集群中运行的服务中的黄金信号指标是指一组指标,可让您检测特定持续时间内的潜在异常。当 Kubernetes 集群中有数百个微服务时,识别频繁出现问题的服务可能会很困难。以下三个关键指标是黄金信号指标,NetScaler Console 图表可以帮助您识别 Kubernetes 服务的潜在异常:
-
命中数
-
响应时间(平均值)和响应时间(P99)
-
错误
作为管理员,使用这些指标,您可以:
-
识别服务状态
-
严重 – 服务在多个指标中存在异常或阈值违规
-
审查 – 服务在任一指标中存在异常或阈值违规
-
良好 – 服务无异常或无阈值违规
-
-
分析每个指标中识别出的异常数量
-
排查问题并避免任何重大影响
识别异常
当您单击服务并选择“查看详细信息”时,服务详细信息页面将显示所有指标的概览。单击“带异常的指标”选项卡以查看异常详细信息。
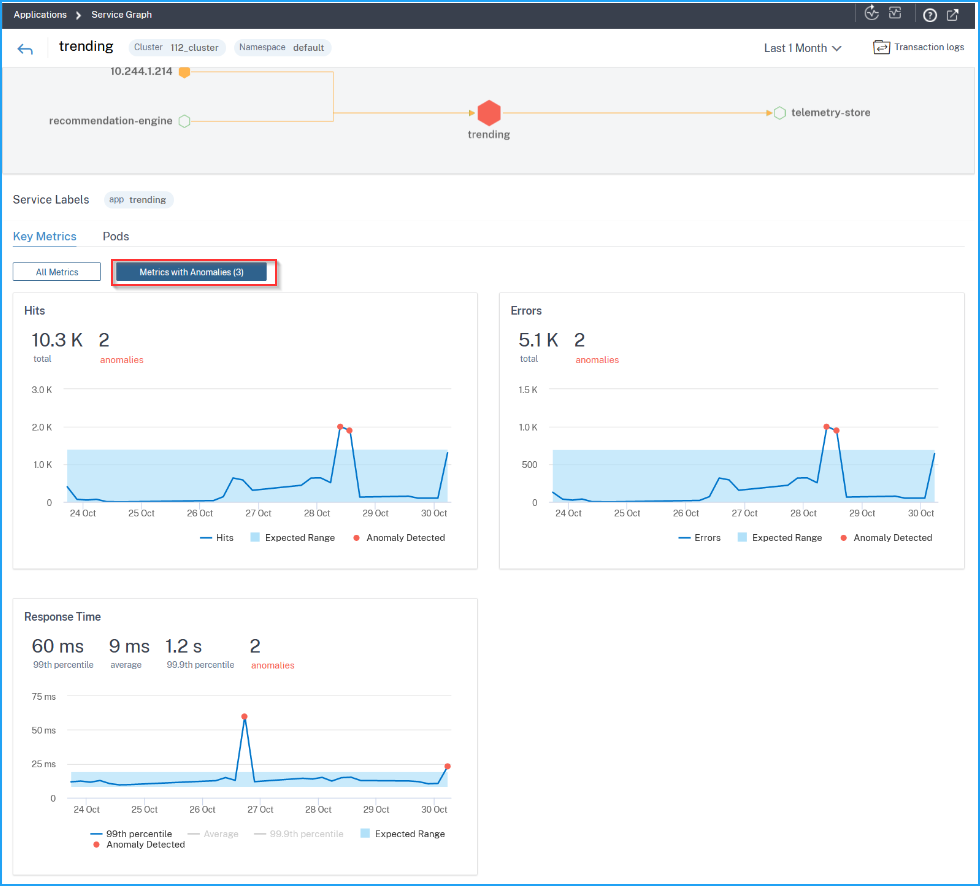
对于每个指标,图表使您能够查看每当超出预期范围时检测到的异常。您可以单击选项以筛选图表中的视图。
筛选图(/en-us/netscaler-console-service/media/anomalies.gif)
假设您要分析服务响应时间 (P99) 的异常情况。
在响应时间下,您可以查看所选时间段的以下详细信息:
指标 P99(/en-us/netscaler-console-service/media/metrics-p99.png)
-
99 百分位 – 表示所选持续时间内 99% 的请求小于 60 毫秒
-
平均值 – 表示服务的平均响应时间
-
99.9 百分位 – 表示服务的最高响应时间
-
异常 – 表示检测到的异常总数
该图还使您能够查看所选时间段的预期范围。根据示例,您可以查看:
-
预期响应时间范围在 1 毫秒到 9 毫秒之间。
-
检测到服务有两个异常(一个为 60 毫秒,另一个为 25 毫秒),因为服务响应时间已超出预期范围(介于 1 毫秒和 9 毫秒之间)。